F. Tokuda, S. Arai and K. Kosuge, “Convolutional Neural Network-Based Visual Servoing for Eye-to-Hand Manipulator,” IEEE Access, vol. 9, pp. 91820-91835, 2021.
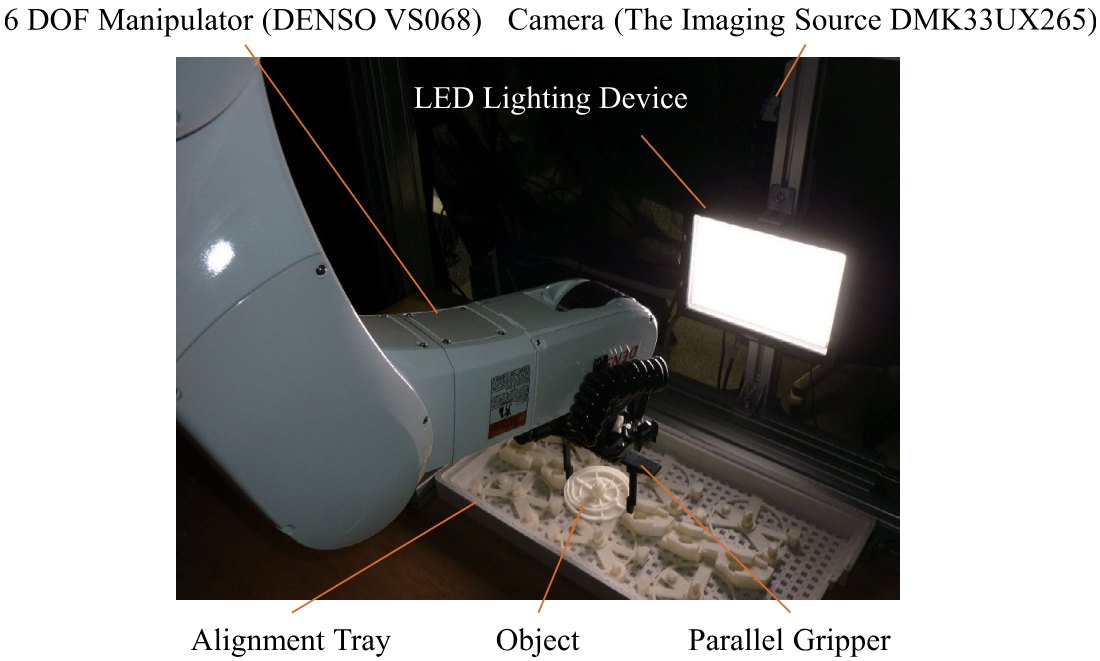
物体を目標の位置・姿勢に合わせるには、カメラ画像の変化をロボットの動きに結びつける必要があります。この研究では、ロボットの外に固定したカメラ(eye-to-hand)の画像から、その動きを学習で求めました。
提案したDEFINetは、重みを共有するCNNで目標画像と現在画像をそれぞれ特徴に変換し、その差から相対的な位置・姿勢を推定します。学習には、ロボットを動かして集めた画像と動作の組を使います。
シミュレーションと6自由度の産業用ロボットによる実機実験で、位置決めの性能を評価しました。2019年の計測自動制御学会論文集の論文が最初の成果で、2021年のIEEE Access論文はその発展です。
実験動画
動画が表示されない場合はGoogle Driveで開いてください。
関連する筆頭論文:徳田冬樹,荒井翔悟,小菅一弘,“深層学習に基づくビジュアルサーボによる物体の位置決め,” 計測自動制御学会論文集,vol. 55,no. 11,pp. 717-725,2019.